

Perusahaan teknologi Meta meluncurkan “Muse Voice Transcribe”, model kecerdasan buatan (AI) pengenalan suara yang dirancang untuk melakukan transkripsi secara real-time.
Meta menyebut Muse Voice Transcribe merupakan model “real-time audio perception” pertamanya.
Muse Voice Transcribe dibekali kemampuan mengenali lebih dari 20 pembicara dan telah dilatih menggunakan lebih dari 70 bahasa. Dari jumlah tersebut, 25 bahasa telah melalui proses verifikasi secara ekstensif.
Model ini juga dirancang mampu menangani percakapan multibahasa, termasuk ketika seseorang berganti bahasa di tengah percakapan. Selain itu,Muse Voice Transcribe dapat memproses percakapan berdurasi lebih dari satu jam.
Model ini diklaim mampu unggul dari sejumlah model pesaing dalam beberapa benchmark pemrosesan suara secara real-time.
Dalam benchmark AA-WER Streaming speech-to-text dari Artificial Analysis, Muse Voice Transcribe mencatat word error rate (WER) sebesar 3,1 persen untuk percakapan berbahasa Inggris.
Angka tersebut lebih rendah dibandingkan sejumlah model lain, seperti Cartesia Ink-2 dengan WER 3,4 persen, ElevenLabs Scribe v2 Real-time 3,6 persen, GPT Live Transcribe 3,9 persen, dan Gemini 3.5 Transcribe Live 4 persen.
Untuk diketahui, semakin rendah persentase WER, maka semakin sedikit kesalahan kata yang dibuat model ketika mengubah ucapan menjadi teks.
Namun, benchmark tersebut hanya menguji kemampuan transkripsi untuk bahasa Inggris.
Muse Voice Transcribe juga diklaim unggul dalam mengenali pembicara yang berbeda. Pada sejumlah benchmark standar untuk penggunaan real-time, model ini mencatat tingkat kesalahan sebesar 17,5 persen.
Cara kerja Muse Voice Transcribe
Menurut Meta, Muse Voice Transcribe merupakan model multimodal autoregresif dari keluarga Muse Spark.
Sistemnya menerima audio dalam potongan berdurasi 80 milidetik, atau 12,5 potongan per detik. Setiap potongan dikompresi menjadi satu soft token.
Pada setiap potongan audio, model menentukan apakah akan langsung menghasilkan text token atau menunggu audio berikutnya
Jika masih membutuhkan konteks tambahan, sistem menggunakan penanda khusus yang kemudian digantikan dengan potongan audio berikutnya.
Ketika audio berhenti, sistem memberikan tanda bahwa tidak ada lagi audio yang masuk. Model kemudian mengeluarkan teks yang masih ditahannya.
Mekanisme tersebut memungkinkan model menentukan sendiri seberapa banyak konteks audio yang dibutuhkan sebelum menghasilkan sebuah kata. Meta menyebut pendekatan ini sebagai “adaptive delay”.
Dengan pendekatan tersebut, kata-kata yang mudah dikenali dapat ditranskripsikan hampir secara langsung, sedangkan kata-kata yang lebih sulit mendapatkan konteks audio tambahan sebelum diproses.
Kemampuan menentukan tingkat penundaan tersebut dipelajari model melalui proses reinforcement learning.
Dalam proses ini, Meta memberikan reward berdasarkan dua faktor, yakni akurasi transkripsi dan rendahnya latensi. Kedua reward tersebut dikalikan, sehingga model terdorong untuk menghasilkan transkripsi yang akurat sekaligus cepat.
Mekanisme serupa juga digunakan untuk membantu sistem mengenali pembicara yang berbeda.
Bisa transkrip suara di Mac
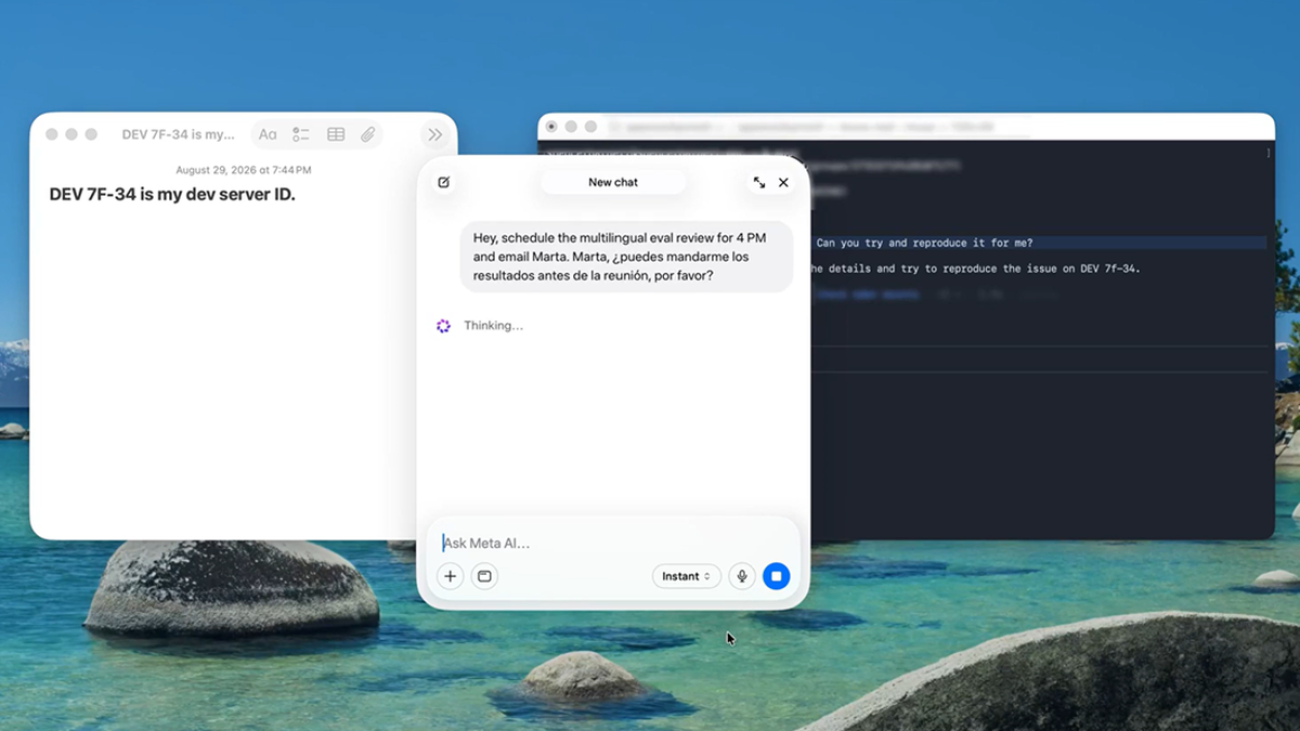
Muse Voice Transcribe tersedia melalui Meta Model API, Meta AI untuk Mac, dan Muse Code. Di Mac, pengguna dapat menekan dan menahan tombol Fn untuk mendiktekan teks ke aplikasi apa pun.
Kemampuan tersebut juga diperlihatkan dalam sebuah demo. Dalam video tersebut, pengguna memberikan instruksi kepada Muse Code menggunakan suara. Ucapan pengguna kemudian langsung ditampilkan sebagai teks di antarmuka Muse Code, sebelum perintah tersebut diproses oleh AI.
Untuk penggunaan melalui API, Meta menetapkan harga 3 dollar AS (sekitar Rp 53.310) per 1.000 menit audio, atau sekitar 0,18 dollar AS (sekitar Rp 3.199) per jam.
Berbeda dari model Muse Glimmer, Meta tidak akan menyediakan bobot model (open weights) Muse Voice Transcribe untuk publik, dihimpun dari The New Stack.

Leave A Comment